OmniHuman 1.5
- 时长
- 1–30s
- 分辨率
- 720p
低至 140 积分
上传单人照片和 WAV 录音,制作由音频驱动的数字人视频。先查看模型、素材要求及积分报价,再检查生成效果。
准备你想使用的肖像和已经录好的声音。这一流程通过上传的 WAV 录音驱动照片中的单个人物,不会把输入文字直接转换成配音。清晰可见的面部与干净的录音更便于后续检查口型、表情和声音节奏。
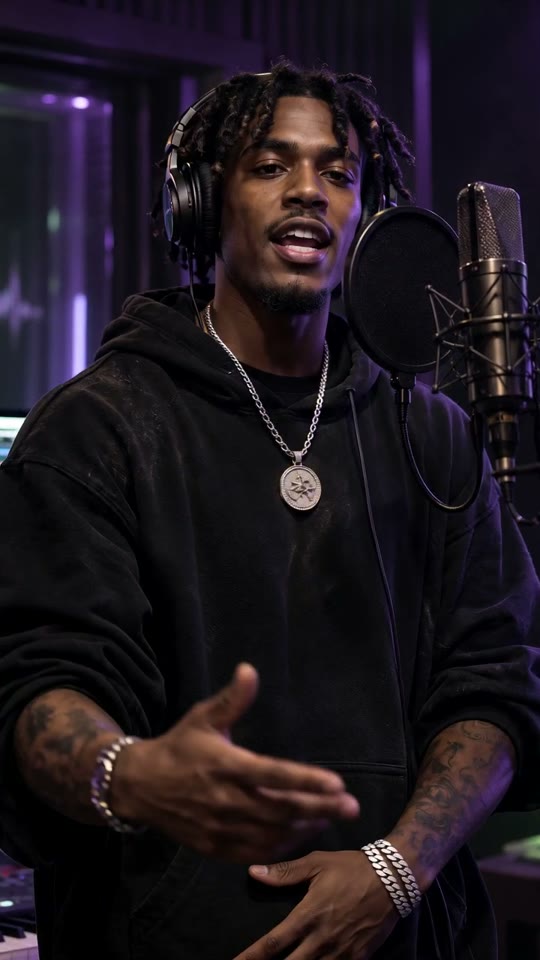
通用概念演示,用于说明创作方向,不代表本功能的实测输出。
单人肖像 + WAV 录音
检查口型、表情与声音同步
上传一张面部清晰、遮挡较少的单人照片,明确由谁出镜。
在本页上传符合要求的 WAV 录音,选择模型并核对可用时长和积分报价。
在本页确认并生成视频,试听声音,检查口型、表情和人物外观是否适合发布。
低至 140 积分
用准备好的欢迎语或自我介绍录音,让肖像呈现一段开场说明。
使用已录制的短讲解,为教学内容制作人物讲述画面。
使用有权使用的角色图像和录音,探索一段预先准备的角色对白。
当前流程需要上传 WAV 录音,不包含文字转语音,也不会自动生成声音。
使用单人肖像和支持的未压缩 WAV 录音。具体格式、大小及时长限制请查看所选模型的输入提示。
建议使用单个主体清晰可见的照片。多人合照或面部遮挡可能让模型无法明确需要驱动的人物。
不能保证。发布前应检查口型、面部细节及声音同步,快速说话或较大表情变化尤其需要复核。
根据发布平台选择画面格式、配乐与 AI 标识,以下官方指南说明了相关选项。
YouTube 将最长三分钟的方形或竖屏视频归为 Shorts。希望使用竖屏形式时,可选择对应的视频导出比例。
TikTok 为商业内容提供商用音乐库。在为无声模板添加歌曲前,请查看该曲目允许的使用位置。
YouTube 说明了逼真 AI 场景与生成音乐何时需要披露。分享表演前,可查看上传时的标识说明。